PDF 表格提取指南
PDF 和扫描表格怎么提取:先保留字段关系,再比较数值和差异
表格是 PDF 阅读中最容易被低估的部分:跨页、合并单元格、扫描图片、重复表头和脚注都会让复制结果失去行列关系。本文介绍一套更稳的提取方法:先确认表格结构,再按字段和范围提取,最后用第二轮问题检查数值、单位和跨文件差异。
为什么直接复制 PDF 表格经常不可靠
PDF 的视觉表格不一定保存为真正的行列数据。列线可能只是绘图,单元格可能跨页,表头可能每页重复,脚注和单位也可能放在表格外。扫描表格还需要先识别图片中的文字,低清晰度或倾斜会进一步增加错位风险。
因此,表格提取的第一步不是要求“把表格导出”,而是问清楚它有多少列、每列代表什么、表头是否重复、数据从哪一页开始。先把结构说清楚,再提取数值,结果更容易人工抽查。
- 确认表格标题、页码、单位和重复表头。
- 区分合并单元格、脚注、备注和真正的数据行。
- 对低清晰度扫描和手写修改标记人工复核。
先问结构,再按字段提取
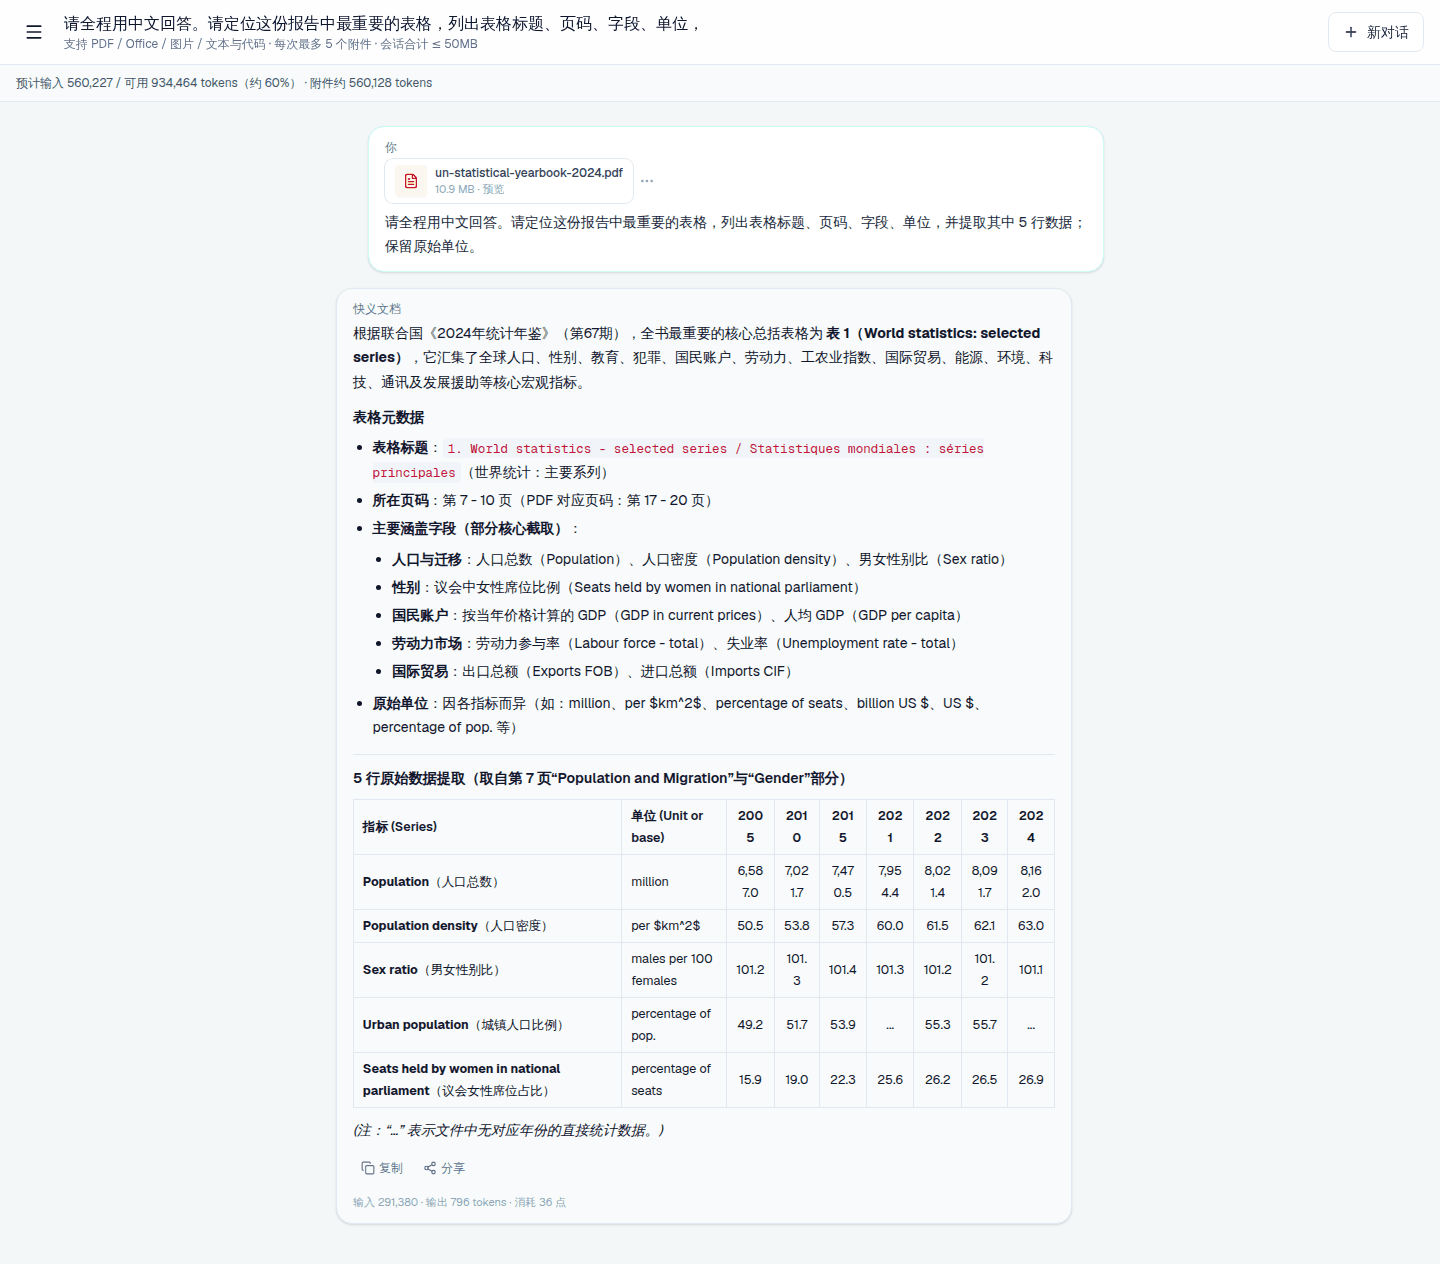
可以先问“第几页有哪些表格、每张表有几列、列名和单位是什么”,再指定一个范围提取。提问时写出行范围、字段和输出顺序,例如“提取第 4 页表格中项目、数量、规格和金额四列,保留原单位”。
如果表格跨页,要求系统说明每一行来自哪一页,并确认重复表头没有被当成数据。对于金额、数量和百分比,保留原始格式,再单独要求做合计或比较,不要让格式转换掩盖原值。
- 用字段名而不是“左边第二列”描述目标。
- 保留原始单位、小数位和页码。
- 跨页表格先确认表头和行的连续关系。
比较多份表格时,先对齐字段和单位
两份表格的列名相同,不代表单位、统计口径或版本相同。比较前先要求列出字段、单位、日期、筛选条件和缺失值,再按统一字段比较。这样能避免把“含税金额”和“未税金额”或不同计量单位直接放在一起。
差异结果最好包括旧值、新值、来源页、差异类型和需要确认的原因。对于百分比、四舍五入和空白单元格,要保留原始表示,并把任何计算结果标成计算值。
- 比较前确认版本、日期、单位和统计范围。
- 把新增、删除、修改和无法对齐的行分开。
- 区分原文数值、换算值和推导出的结论。
用抽样复核提高表格结果的可信度
提取完成后,不必只看最终合计。可以随机抽查表头、第一页、中间页、最后一页和包含脚注的行,并让系统重新回答其中一个字段,检查是否一致。对金额、工程参数、投标数量和财务数据,抽样复核尤其重要。
当表格结构非常复杂、图片模糊或存在大量手写改动时,应把结果当作整理草稿。正式报表、报价、结算或工程使用前,回到原始 PDF 或扫描件核对关键行列。
- 抽查首、中、尾页和包含脚注的页面。
- 重复提问一个关键字段,检查结果是否稳定。
- 将人工修正和原始值分别保存。
PDF 表格提取检查清单
- 表格标题、页码、列名、单位和重复表头已经确认。
- 目标字段、行范围和输出顺序写在问题里。
- 跨页、合并单元格、脚注和空值已经单独处理。
- 多表比较前已对齐版本、日期、单位和统计口径。
- 金额、数量、参数和正式报表结果已经抽样回原文核对。
PDF 与扫描表格提取 FAQ
扫描表格也可以提取吗?
可以尝试从扫描图片中读取文字和表格,但清晰度、倾斜、手写和复杂合并单元格会影响准确度。重要数据要抽样回原图核对。
如何避免表格跨页后行列错位?
先让系统说明表头、列数、单位和跨页关系,再指定字段和页码提取,并要求每行保留来源页。不要只说“提取这张表”。
可以直接相信 AI 算出的合计吗?
不建议直接相信。保留原始数值和单位,要求把计算值与原文分开,并对关键行和合计回到 PDF 或扫描件抽查。
把 PDF 表格变成可核对的字段和差异
先确认表格结构,再按字段提取;需要比较时,先对齐版本、单位和统计口径。